من نظرية الألعاب إلى Stable Diffusion: القصة الكاملة لتوليد الصور
رحلة تفصيلية وممتعة تأخذك من الصفر؛ من نشأة شبكات GAN ونظرية الألعاب، مروراً بالـ Diffusion وMidjourney وDALL-E، وصولاً إلى كيفية تشغيل Stable Diffusion مجاناً على جهازك أو عبر Google Colab.
الـ Game Theory هو علم التحليل الرياضي للمباريات والمنافسات. العلم ده بيستخدم كتطبيق فعلى في علوم الاقتصاد والاجتماع والسياسة، والأهم فيهم في نطاق كلامنا هنا، علوم الكمبيوتر.
من ضمن نظريات الـ Game Theory هي الألعاب صفرية المجموع Zero Sum Games، وهي اللعبة اللي مكسب الطرف الأول فيها بيساوي بالزبط خسارة الطرف التاني، يعني موارد اللعبة من أول اللعبة ثابتة، لا تفنى ولا تستحدث؛ في النوع ده من الألعاب مينفعش الطرفين يكونوا كسبانين، ومقابل كل فائز هيكون فيه خاسر.
The Rise of Technical Art
في سنة 2014 عالِم الكمبيوتر والذكاء الإصطناعي Ian Goodfellow هو وزمايله عملوا أول شبكة ذكاء إصطناعي من نوع GAN.
شبكات GAN أو Generative adversarial network هي نوع من برامج الذكاء الإصطناعي مكونة من شبكتين ذكاء إصطناعي بينافسوا بعض في zero sum game.
- الشبكة الأولى: وهي الشبكة المنتجة، بتحاول تعمل داتا جديدة من داتا موجودة (تنتج صورة جديدة من مجموعة صور مثلاً).
- يروح برنامج وسيط يلخبط الداتا الجديدة دي مع داتا من الاصلية ويعرضها على الشبكة التانية.
- الشبكة التانية: وهي الشبكة التمييزية، بتحاول تتعرف على الداتا الجديدة من الداتا الأصلية، ثم البرنامج الوسيط يدي الشبكة الأولى Score بناءً على تقدير الشبكة التانية.
العملية تتكرر كتير لغاية ما الشبكة التانية متقدرش تعرف الداتا الجديدة من الأصلية، وبكدة بقى عندنا برنامج كامل يقدر ينتج نوع معين من الداتا بكفاءة.
تطبيقات وأدوات الـ GAN
أهم تطبيق على برامج الـ GAN من وجهة نظري هو StyleGAN واللي بالمناسبة بيستخدم برامج GAN متعددة جواه. هو برنامج طورته شركة انفيديا وظيفته الأساسية إنتاج صور بخصائص معينة بتحددها.
كل الصور اللي على thispersondoesnotexist.com معمولة بالبرنامج ده.
المطورين إستخدموه في برنامج تاني Latent Encoder وظيفته يحول أي صورة لمجموعة من الخصائص اللي تخلى StyleGAN ينتج صورة زي الصورة اللي انت دخلتهاله بالزبط (أو قريبة جداً منها يعني).
ده بيسمحلك تعدل على خصائص معينة في الصورة، أهم إستخدام ليه كان في التعديل على وجوه الأشخاص؛ تطلعلهم شنب، تقلل/تزود عمرهم، تغير الملامح بين ذكورية وأنثوية، تشوف شكل الشخص مع لحية طويلة وحاجات تانية ملهاش لازمة أكتر من شوية قهقهات مع صحابك، بس أهم حاجة من دول كانت إنك تخلى شخص يبتسم.
الـ Technical Artist هو مصمم بيستخدم البرامج والبرمجة لإنتاج التصميمات والصور والفن بشكل عام. المصممين دول لسة بيستخدموا البرنامج ده في ترميم الصور القديمة؛ واحد جدّه متوفي مش لاقيله صورة سليمة فبيدي الصورة القديمة اللي معاه لمصمم يرممها ويطلب منه يضيف ابتسامة عالصورة، أفضل طريقة لإضافة الابتسامة دي هي بـ StyleGAN.
عيوب تقنيات الـ GAN
سنة 2015 باحث في شركة جوجل اسمه Jascha Sohl-Dickstein اقترح فكرة جديدة وهي عكس عملية التدريب بتقنية اسمها الـ Diffusion.
شوف، تقنيات GAN كانت حلوة وكل حاجة بس واجهتها مشاكل كتير، بالبلدي كدة الشبكة المنتجة مكانتش عارفة هي رايحة فين، هي كانت بتعرف اللي عملته صح ولا غلط، بس كدة، متقدرش غير إنها تقعد تجرب حاجات جديدة لغاية ما الحظ يضرب. ده سبب عدد كبير من المشاكل، نذكر منها مشكلتين:
- مشكلة vanishing gradient: لو الشبكة التانية (التمييزية) كانت قوية وبتعرف تفرق بين الداتا الأصلية والإصطناعية بشكل كويس جداً فممكن الشبكة الأولى تعمل نتيجة مقنعة بما فيه الكفاية بالنسبة للبشر بس الشبكة التانية تلقطها بسهولة وبالتالي النتيجة الممتازة دي هتتلغي وتعتبر غير مجدية والتدريب هياخد وقت أطول بآلاف المرات.
- مشكلة Mode Collapse: وهي لما الشبكة المنتجة تعمل نتيجة واحدة مقنعة جداً فالشبكة التمييزية تديها Score عالى، ساعتها ممكن الشبكة المنتجة متتعلمش غير إنها تعمل النتيجة دي وبس! يعني ممكن تكون عاوز تنتج وشوش أشخاص مثلاً، فالشبكة المنتجة تعمل وجه شخص مقنع جداً فياخد Score عالى فالشبكة تتعلم إن ده الوجه اللي المفروض دايماً تعمله ومتتعلمش إزاي تعمل غيره.
تقنية الـ Diffusion ونشأتها
الباحث Sohl-Dickstein من جوجل كان بيذاكر Thermodynamics لما لاحظ إزاي لما يكون فيه مائعين من نفس المادة درجة حرارتهم مختلفة لما يتحطوا على بعض بيبدأوا يختلطوا ببطئ لغاية لما كلهم يبقوا مادة واحدة ولو خدت معلقة منهم عمرك ما هتعرف دي كانت في المائع الأول ولا التاني...
لو متعرفش، فأي داتا عشوائية تماماً لازم تتبع منحنى التوزيع الطبيعي Normal distribution، ولما نرسم الداتا دي في function بنقول عليها Gaussian function ودي بتكون إشارة لتمام العشوائية في مجموعة الداتا دي.
على العكس أي داتا غير عشوائية بيكون ليها Structure معين أو بنية محددة تقدر تتعرف عليها إنت كبشري زي ما كنت بتحل "أكمل بنفس التسلسل" وانت صغير.
المهم الباحث قال أما نشوف الذكاء الإصطناعي هيقول إيه بخصوص الموضوع ده، فجاب مجموعة من الداتا العشوائية تماماً وهي بالنسبالنا هنا Noise ومجموعة من الداتا السليمة اللي ليها بنية واضحة وهنا هي المائعين منفصلين بشكل واضح عن بعض.
بدأ يضيف جزء صغير من الـ Noise مكان الداتا السليمة وبدأ يدرب برنامج ذكاء إصطناعي على إنه يشيل الـ Noise ده. كل خطوة كان بيزود الـ Noise ويخلى الـ AI يحاول يشيله لغاية ما بقيت الداتا كلها Noise بس والـ AI بيطلع منها صورة واضحة بتفرق المائع الأول عن التاني.
عشان يتم إستخدام برنامج زي ده لازم يكون فيه مساعد أو Guide يقول للـ Diffusion Model هو عايز يوصل لإيه.
ثورة اللغات والصور (GPT و CLIP)
في سنة 2020 فريق من شركة OpenAI بتاعت إيلون ماسك نشر GPT-3 وهو برنامج ذكاء إصطناعي لغوي بيعمل كل حاجة ليها علاقة بالنصوص. بيعرف يترجم، يألف، يبرمج، ويفهم الكلام اللي انت كاتبهوله ويرد عليه. البرنامج ده قاري النت كله تقريباً ولسة بيقرا كل جديد لحظة بلحظة، طبعاً ده خلاه يبقى مكلّف جداً عالشركة وبالتالي البرنامج ده مش Open Source ولا مجاني.
لحسن الحظ بالنسبالك عزيزي الفقير إلى الله، نفس الشركة كانت نشرت GPT-2 مجاني ومفتوح المصدر سنة 2019، وطبعاً ده خلى الناس تساعد في تطويره وبيقدر يعمل ما يكفي للغرض اللي هنتكلم عنه كمان شوية.
التيمز اللي في OpenAI لما شافوا اللي يقدر GPT-3 يعمله أول حاجة جت في دماغهم هي: "إزاي نخلى البرنامج ده يوصف نفسه بالصور بدل الكلمات؟!"
جربوا يجيبوا شوية صور من النت بالوصف النصي بتاعهم (250 مليون صورة ووصف بالتحديد) ودربوا برنامج ذكاء إصطناعي علي الربط بينهم. البرنامج ده نجح يربط بين النصوص والصور، بقى زي محرك بحث للصور كدة، تكتب حاجة تجيلك مجموعة صور للحاجة دي، بس مبيقدرش يصنع صور جديدة.
البرنامج طبعاً كان بيغلط، فالخطوة التانية كانت التفريق بين الصور وإيجاد أفضل صورة للتعبير عن النص. الحل كان برنامج CLIP وهو برنامج بيستخدم الخطوة اللي فاتت بطريقة مختلفة. بياخد مجموعة نصوص والصورة واحدة، ويطلع أفضل نص يوصف الصورة من مجموعة النصوص دي، والفريق نشره مجاني ومفتوح المصدر.
سباق إنشاء الصور (DALL.E, Midjourney, Stable Diffusion)
في الأثناء دي كانت تقنية الـ Diffusion بدأت تتفوق على تقنيات الـ GAN في مجال إنشاء الصور.
- Google SR3: على سبيل المثال جوجل في شهر 5 سنة 2021 نشرت برنامج
SR3: Image Super-Resolution، وهو برنامج بيستخدم الـ Diffusion في زيادة دقة وتفاصيل وجوه الأشخاص، بيبدأ من Noise بالكامل ويشيل الـ Noise ده بناءً على الصورة الأصلية (وهنا بيتم إستخدام الصورة الأصلية كمساعد أو Guide)، التقنية دي موجودة بشكل مخفف عشان يشتغل عالموبايلات في Google Camera 8.4 اللي نزلت في سلسلة Pixel 6. - DALL.E & GLIDE: شركة OpenAI دمجت GPT-3 و CLIP وتقنية الـ Diffusion مع بعض في برنامج اسمه GLIDE وده كان أساس برنامجها الشهير DALL.E اللي اتنشر في مرحلة البيتا المفتوحة أول مرة في 5 يناير 2021. شركة OpenAI تابعت التقدم ده لما نشروا DALL.E 2 في شهر 5 سنة 2022 وهو أقوى AI لإنشاء صور واقعية لغاية دلوقتي.
- Midjourney: بس في شهر 5 مكانوش لوحدهم في السباق، فيه كتير كانوا بدأوا يعملوا برامج مشابهة أهم واحد واللي كلكم عارفينه هو Midjourney اللي دخل البيتا المفتوحة يوم 12 شهر 5. برنامج Midjourney هو برنامج بيقدر ينشئ صور فنية جميلة مهما كان النَص اللي كتبته، لكنه فاشل تماماً في إنشاء صور حقيقية وده لسبب مهم، وهو إنه معمول في الأساس عشان يتعمل بيه فن، مش عشان يتعمل بيه صور متفبركة. برنامج Midjourney برنامج مدفوع مش مجاني ومش مفتوح المصدر وبالتالي إحنا منعرفش هو شغال ازاي ولا عملوه ازاي بس تقدر من الصور اللي بينتجها تعرف إنه متدرب بكثافة على الأعمال الفنية بدل الصور الحقيقية.
- Craiyon (DALL.E Mini): في نفس الشهر اتنشر برنامج DALL.E Mini وهو محاولة لإنشاء برنامج شبيه بـ DALL.E بس مفتوح المصدر، لاحقاً شركة OpenAI قالت للي نشره بالذوق إن الإسم ده لازم يتغير وبالفعل بقى اسمه Craiyon. برنامج Craiyon من اسمه الأصلى DALL.E Mini هو برنامج خفيف جداً من حيث الموارد المستهلكة لدرجة إنك هتلاقيه مفتوح وتقدر تستخدمه من المتصفح مباشرةً على أكتر من موقع، لكن ده جاي بسعر مناسب وهو إن الصور اللي بيطلعها جودتها سيئة في أفضل الأحوال، البرنامج كل يوم بيتدرب بس ليه حدود واضحة.
Stable Diffusion: البطل الجديد
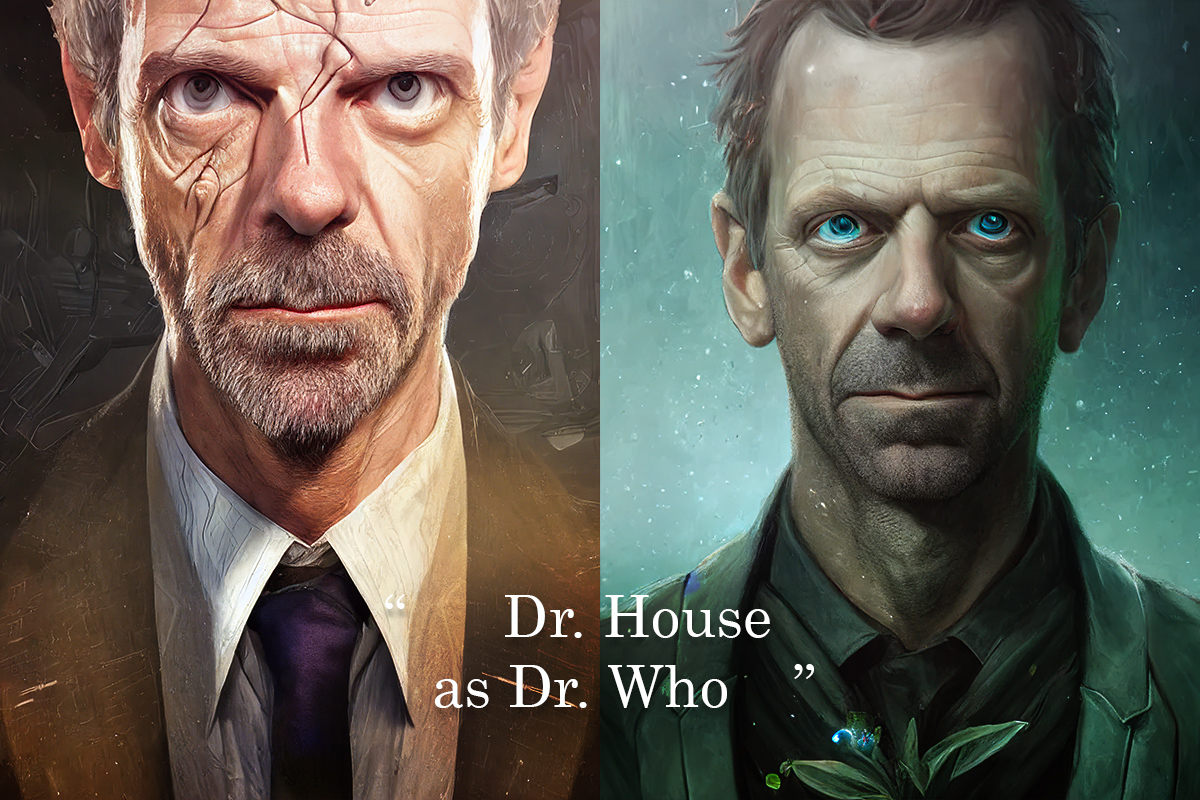
اللي عامل الصورة اللي قدامك دي بقى هو برنامج مجاني ومفتوح المصدر من شركة stability.ai اتنشر في يوم 22 شهر أغسطس سنة 2022 اسمه 🥁🥁🥁
Stable Diffusion
البرنامج ده هو أول منافس حقيقي لـ DALL.E 2 وما هي إلا مسألة وقت عشان يقدر يهزمه، كونه مفتوح المصدر ومجاني وبالنتايج اللي بينتجها دي خلاه ياخد شهرة واسعة جداً وكل الناس كانوا بيتكلموا عنه خلال الشهر اللي فات ده.
المشاكل ومتطلبات التشغيل
مشكلته الوحيدة؟ محتاج جهاز، جهاز قوي. أول ما نزل مكانش ينفع تشغله بأقل من 12 جيجا Vram!
رقم خيالى بالنسبة لأغلب الناس بس برضه ساعتها مكانش صعب أوي إنك تشغله. جوجل عاملالك موقع Google Colab بتقدملك فيه جهاز بكارت Tesla T4 (أغلب الوقت) بـ 12 جيجا Vram وصفحة تكتب فيها كود بايثون زي ما انت عايز.
كل من هب ودب راح عامله Colab Notebook لتشغيل Stable Diffusion والمنافسة على السهولة والسرعة والتحكم لغاية دلوقتي مستمرة فلو معندكش كارت شاشة من أساسه وعايز تجرب البرنامج، تقدر تجربه وهشرحلك الطريقة في الآخر.
البرنامج متدرب على صور 512×512 فهيطلع أفضل نتايجه في الدقة دي، ده غير إن الـ Vram بتاعتي وبتاعتك مش هتكفي صورة أكبر من كدة، بس لسة فيه تريكاية تانية مستخبية هقولك عليها بعدين.
المهم عدى 3 أسابيع من الـ Optimization والبرنامج بقى بيشتغل على 4 جيجا Vram، مش سريع أوي بس بيشتغل...
- على كارت GTX 1650 في لاب توب Legion Y540 بيخلص صورة
512×512في حوالي دقيقتين، تقدر تقلله عن كدة عن طريق تقليل الـ Steps ومش هتضحى بتفاصيل. - ليه مش هتضحى بتفاصيل؟ دي بقى فرصة هايلة عشان أقولك على مشكلة كمان، في كروت الـ 16XX بتحصل مشكلة إن الصورة الناتجة بتبقى خضرا أو سودا، محدش عارف تفاصيل السبب بس ده بيحصل لما تشغل الموديل بخاصية
autocastاللي بتخلي كل الأرقام توصل لنُص الـ precision الأصلى وبالتالي إستهلاك Vram أقل وتفاصيل أقل بس سرعة أعلى بكتير (الضعف تقريباً)، بس لما بتشغله بالـ Full precision بيشتغل زي الفل. - المشكلة بقى إن صاحبك اللي معاه RTX 2060 ممكن ياخد نفس الـ seed ونفس الـ prompt ونفس الـ resolution ويطلع نتيجة مختلفة تماماً، وممكن تطلعوا نتيجة قريبة من بعض بس التفاصيل في الـ 16xx أكتر عشان الـ Full precision.
- فيه خيار إنك تشغله على البروسيسور بس هيقعدلك بتاع ربع ساعة في الصورة الواحدة على إستهلاك قريب من 100% وهيطلع نتيجة مختلفة عن الاتنين التانيين (مش بالضرورة النتيجة المختلفة تبقى سيئة).
- الصورة الواحدة على الـ RTX 2060 في لاب توب Legion 5 بتاخد حوالي 30 ثانية بس وممكن أقل لو عايز تضحى بتفاصيل بسيطة.
⚠️ لو من أصحاب عيون الصقر هتلاحظ غياب كروت AMD من المحادثة دي، ده لإن البرنامج زي زي أغلب برامج الذكاء الإصطناعي المتعلقة بالصور، بيشتغل على CUDA ومش متوفر نهائياً لكروت AMD، دي إشارة إنك مجنون لو بتفكر تجيب كارت AMD لأي حاجة غير الجيمينج.
مشكلة الريزولوشن والـ Upscaling
عموماً كفايانا حزن على حالنا، نرجع لمسألة الريزولوشن. حالياً مفيش Upscaler رسمي لـ Stable Diffusion. على النقيض Mid Journey بيقدر يزود التفاصيل لأبعاد أعمق بكتير بعد ما يديك معاينة صغيرة عن طريق الـ Upscaler الرسمي بتاعه.
الحل الرسمي لـ Stable Diffusion هو بما إن البرنامج بيطلع صور تفاصيلها كويسة بس صغيرة، فاستخدام برنامج Upscaler من اللي موجودين في السوق هيبقى حل مناسب، وما أكثر برامج الـ Upscaling، اكتب بس في جوجل Upscaler وهيطلعلك عشرات البرامج اللي بتقوم بالمهمة دي، بس أكيد فيه واحد أحسن من اللي بعده.
الخيارات المتاحة للـ Upscaling:
- Topaz Gigapixel: أكثر خيار متوازن من حيث السرعة والجودة هو وللأسف خيار مدفوع وهو برنامج Gigapixel من شركة Topaz، سعره حاجة توجع قلبك يا مصري وهو
$99.99، للتوثيق بس السعر ده معناه 2000 جنيه مصري في وقت كتابة المقال ده، بس بالنظر مرتين فإنت بتدفع مرة واحدة مش اشتراك وبتاخد سنة تحديثات وبتشغله على جهازين في نفس الوقت بنفس الأكونت، زيادة عن كدة تمديد التحديثات لسنة إضافية بـ$60ومظنش إنك هتحتاج تمد التحديثات إلا كل 3 سنين مثلاً. - RealESRGAN: فيه برنامج مفتوح المصدر اسمه
realESRGANبيستخدم أحد تقنيات الـ GAN لتكبير الصور، جودته متواضعة بس hey, open source. - LDSR (Latent Diffusion Super Resolution): التريكاية بقى إن فيه برنامج اسمه
Latent Diffusion Super Resolutionأو LDSR، أيوة زي ما سمعت كدة Upscaler بيشتغل بالـ Diffusion ومفتوح المصدر كمان.- للأسف حاولت أشغله على الـ 1650 بتاعي وفشلت، البرنامج محتاج بالزبط 4.8 جيجا Vram.
- محاولتش أشغله عالبروسيسور لسة بس هو مشروع للمستقبل لما التقنية تنضج شوية كمان، في الوقت الحالى أقدر أشغله على Google Colab.
- مشكلته يا مؤمن إنه بياخد حوالي ربع ساعة عشان يزود الصورة من
512pxلـ2048px. - ميزته بقى إنه بيكبر الصورة مع إضافة تفاصيل مكانتش موجودة قبل كدة.
أنا وصديقي Abdelrahman Khalil كنا بنتناقش في الموضوع ده لغاية ما لقيته باعتلي لينك الموقع ده fadel.pages.dev. الموقع ده هو اللي عمله وظيفته يقارن بين الصور، عمله مخصوص عشان نقدر نقارن آداء برامج الـ Upscaling المختلفة عشان ببساطة ملقاش زيه 😶
دي مقارنة للصورة اللي عالشمال في البوست بين برامج الـ Upscaling اللي ذكرتها. الموقع لسة مش أحسن حاجة عالموبايل بس بيشتغل بشكل ممتاز عالديسكتوب.
عبد الرحمن خليل ممكن تكونوا عارفينه قبل كدة، هو اللي عامل موقع "أسعار" لتجميع الـ PCs: pcprices.vercel.app. الموقعين مفتوحين المصدر هتلاقوا ملفاتهم المصدرية هنا: github.com/SamyzKhalil
طريقة التشغيل والروابط
دلوقتي نيجي للتشغيل. فيه طريقة سهلة جداً وسريعة عشان تشغل Stable Diffusion على Google Colab:
- اعمل حساب هنا huggingface.co وأكّد إيميلك، لاحظ إن الباسوورد لازم يبقى فيها حروف كبيرة وصغيرة وأرقام ورموز (كلهم مع بعض مش بس حاجة واحدة منهم).
- بعدين هتروح عاللينك ده وتدوس New Token: huggingface.co/settings/tokens
- في الـ name اكتب اللي يريحك وليكن
SD colab. - في الـ role خليها
write.
- في الـ name اكتب اللي يريحك وليكن
- انسخ الـ token اللي هيجيلك وخش على النوت بوك دي: bit.ly/SD-Colab-ESY
- في تاني خطوة دخلت الـ Token اللي انت نسخته، وكمل تشغيل خطوة بخطوة (اي مشكلة نزل في الكومنتات).
خيارات متقدمة وطرق أخرى:
- لو عاوز حاجات شكلها أحسن وخصائص زيادة زي upscaling جوا البرنامج وصفحة لوحدها تشتغل عليها فتقدر تخش هنا: bit.ly/SD-Colab-COMPX (بس الموضوع أعقد وأنا مش هوفر مساعدة خطوة بخطوة في الموضوع).
- لو عايز تشغله على جهازك تقدر تغوض هنا: github.com/sd-webui/stable-diffusion-webui أو هنا (اللي أنا بستخدمه): github.com/cmdr2/stable-diffusion-ui ولو محتاج مساعدة بخصوص التاني ده هقدر أوفرهالك.
- أما بالنسبة لـ LDSR فتقدر تشغله على كولاب بطريقة سهلة من هنا: bit.ly/LatentSR-Colab-ar
- أو لو عايز تشغله على جهازك فلسة متعملهوش GUI بس تقدر تنزل الكود اللي في الـ Notebook وتحاول تشغله ولو احتاجت مساعدة بخصوص الموضوع ده هقدر أوفرهالك.
بس كدة، أي استفسارات اكتبوها في الكومنتات وأنا هكون بالانتظار.